
En bref. L’architecture medallion (Bronze, Silver, Gold) reprend les couches que nous utilisons depuis trente ans : landing zone, ODS et data warehouse. Ce qui change, c’est la logistique (ELT plutôt qu’ETL) et un stockage bon marché qui permet de tout conserver. Mieux vaut donc architecturer la fonction de chaque couche que son nom.
Il n’y a rien de nouveau sous le soleil du data engineering. Nous avons simplement changé les étiquettes, et nous avons accepté de payer du calcul cloud pour redécouvrir ce que Bill Inmon décrivait déjà en 1992 dans Building the Data Warehouse.
Le terme « medallion » vient de Databricks ; Fabric décrit des couches équivalentes, dbt parle de staging, intermediate et marts. Sous le branding, ce sont les mêmes plans logiques qu’il y a trente ans. Mon travail d’architecte n’est pas de me soucier de la couleur de la couche, mais de sa fonction : quand les coûts de calcul s’accumulent chaque jour, confondre les deux mène vite à un data swamp coûteux.
Comment passer de l’ancien monde au medallion ?
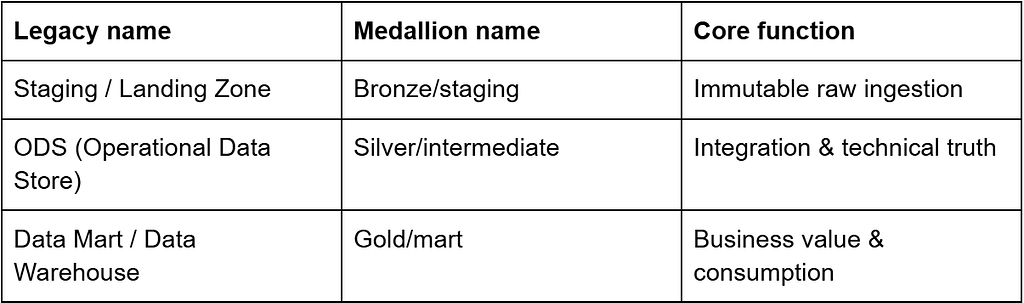
Quel que soit l’éditeur ou l’outil (dbt, Airbyte, Fivetran ou un framework d’ingestion maison), la physique de la donnée ne change pas. Tout pipeline robuste suit la même progression logique en trois étapes.
Bronze est-il autre chose qu’une landing zone ?
Dans le monde medallion, Bronze est l’endroit où la donnée arrive sous sa forme la plus brute. Dans l’architecture classique, c’était la staging area, avec une distinction critique que l’ère cloud a rendue explicite et que la plupart des architectes passent sous silence : la staging area classique était temporaire. Bronze ne l’est pas.
À l’époque de l’ETL, le stockage coûtait cher. Une staging area sur Oracle ou SQL Server était une zone de transit : truncate, load, transform, on recommence, et les tables étaient vides à la fin du traitement de nuit.
Le cloud change ce contrat. Sur S3, GCS ou ADLS, stocker des données brutes coûte peu : environ 22 à 27 dollars par TiB et par mois en stockage Standard Cloud Storage, selon le lieu (calcul à partir des tarifs horaires de Google sur 730 heures ; vérifiez le vôtre). La couche Bronze repose donc sur un principe radicalement différent : on n’écrase jamais, on ajoute seulement (append). La donnée brute arrive exactement comme le système source l’a produite (sans cast de types, sans renommage, sans nettoyage) et elle y reste indéfiniment.
Ce n’est pas cosmétique. Si une transformation échoue dans six mois, ou si un besoin métier change, on rejoue tout le pipeline depuis la source d’origine sans retoucher la base opérationnelle. Bronze est votre police d’assurance, et elle découple le calendrier d’ingestion de celui de transformation.
La règle par défaut est simple : Bronze est une archive en écriture unique et lecture multiple.
Cette règle a une limite : le droit à l’effacement (RGPD) et les durées de conservation. Si Bronze contient des données personnelles, prévoyez rétention, pseudonymisation à l’ingestion ou effacement testé, à valider avec votre DPO. « Rien n’est jamais supprimé » est une règle d’architecture, pas une règle juridique.
Silver est-il l’ODS moderne ?
La couche Silver est celle où le vrai travail d’ingénierie se fait. Elle joue le rôle de l’operational data store (ODS) : le niveau gouverné et intégré entre l’ingestion brute et la consommation métier. La correspondance n’est pas exacte : un ODS classique est à valeur courante, alors que Silver conserve souvent l’historique. Avec dbt, la majorité de vos modèles vivent ici : déduplication, renommage, et historique versionné (SCD Type 2, snapshots dbt ; le time travel de Delta Lake, limité par la rétention des fichiers, n’est pas un SCD Type 2).
Silver n’impose pas l’ACID au sens des bases de données : elle impose des contraintes de qualité, l’idempotence (le pipeline se rejoue sans doublons) et l’intégrité référentielle. L’ACID est une propriété du moteur (Delta Lake, Iceberg), et le CDC un mécanisme d’ingestion, pas une propriété de Silver.
Un cas réel montre ce que Silver doit absorber. Sur mon pipeline de prix des carburants, le job qui rattache chaque station à son enseigne lisait le flux brut du gouvernement sans filtre de fraîcheur. Or ce flux liste toutes les stations jamais référencées, avec des mises à jour remontant à 2009. Sur un run réel, 179 des 180 lignes ajoutées au batch du jour étaient des stations mortes depuis des années ; une seule était active. Le correctif a été le même seuil de fraîcheur que l’ingestion. Le batch pollué a été corrigé en SCD1 (mise à jour en place) plutôt qu’en nouvelle version SCD2 : une correction de qualité n’est pas un vrai changement d’enseigne, et la versionner aurait pollué l’historique.
À la fin de Silver, les données sont propres, standardisées et historisées, mais pas encore orientées métier : un miroir gouverné de la source, la vérité technique et non la réponse métier.
Gold est-il un data warehouse rebaptisé ?
La couche Gold est la destination : data marts et data warehouse traditionnel, ce que vos analystes, vos outils de BI et vos modèles de machine learning consomment réellement. La donnée n’y est plus un enregistrement technique mais une réponse métier : logique métier complexe, jointure de domaines distincts (clients du CRM, commandes de l’ERP) et pré-agrégation pour la performance.
On y retrouve la modélisation dimensionnelle de Kimball, des tables larges, des agrégats ou des jeux de features pour le ML. Chaque décision de conception doit être guidée par la façon dont la donnée sera lue, pas écrite.
ETL ou ELT : qu’est-ce qui change vraiment ?
La vraie révolution de la dernière décennie n’est pas l’architecture : c’est le sens de la transformation.
À l’ère de l’ETL, stockage et calcul des entrepôts étaient chers et rigides : on transformait les données avant de les charger. L’ELT d’aujourd’hui inverse ce contrat : on charge d’abord la donnée brute, puis on la transforme dans la plateforme avec du calcul cloud élastique.
Mais le calcul élastique n’est pas gratuit. Ce n’est pas parce qu’on peut tout transformer en une seule passe qu’on doit fusionner les couches logiques. Un seul script SQL de 800 lignes de Bronze à Gold fait gagner du temps au premier jour. Le risque est de le payer au sixième mois, en débogage, en ruptures de lineage et en retraitements, quand un changement de schéma en amont se propage sans couche d’isolation pour l’absorber (scénario illustratif, non mesuré).
Le coût d’un mauvais choix de matérialisation, lui, est mesuré. Sur mon projet personnel de prix des carburants (staging, intermediate et marts avec dbt sur BigQuery), la couche staging était une vue sur un fichier Parquet de 422 Mo non partitionné : chacun de ses tests relançait la requête entière. Juillet 2026 a facturé 1,353 TiB de lecture, dont 73 % pour les seuls jobs qui lisaient cette archive ; après avoir retiré des tests redondants et ajusté la matérialisation (avec un aller-retour entre vue et table), septembre est tombé à 0,470 TiB. Je n’ai pas isolé l’effet de chaque changement, et à cette échelle la facture se compte en euros (9,93 € en juillet avant crédits, dont 1,94 € d’analyse BigQuery, franchise de 1 TiB déduite, et 3,68 € de transfert) : c’est le mécanisme, pas le montant, qui se transpose. Le retour d’expérience détaillé est dans le REX sur la vue relancée par ses tests.
Que faut-il architecturer : la fonction ou le nom ?
La modern data stack est une vraie évolution en vitesse, en échelle et en expérience développeur, mais elle ne change pas la physique du mouvement des données. Que vous l’appeliez Silver ou ODS, il vous faut une couche intermédiaire gouvernée, intégrée et techniquement saine avant de prétendre apporter de la valeur métier. Sans elle, ce n’est pas une modern data stack : c’est un data swamp avec un meilleur branding.
Un critère pour décider du nombre de couches : chaque couche doit répondre à « quelle panne ou quel changement absorbe-t-elle ? » (Bronze : le rejeu, Silver : les changements de schéma de la source, Gold : l’évolution du besoin métier). Si la réponse est vide, la couche est du branding. Je n’appliquerais pas trois couches à la lettre sur une source unique, petite et stable, ni sur un flux dont la latence interdit trois passages ; je garde alors la fonction et fusionne les noms.
Les noms changeront encore dans cinq ans. La logique, non.
À propos. Je suis Camille Lebrun, Data & IA engineer à Toulouse. Je bâtis et fiabilise des plateformes data : fondations, migration, IA vérifiable. Je documente ici ce que j’applique en mission et dans mes projets. Une migration ou une plateforme à fiabiliser ? Écrivez-moi. camillelebrun.fr · LinkedIn
Article publié à l’origine en anglais sur Dev Genius.